

摘要
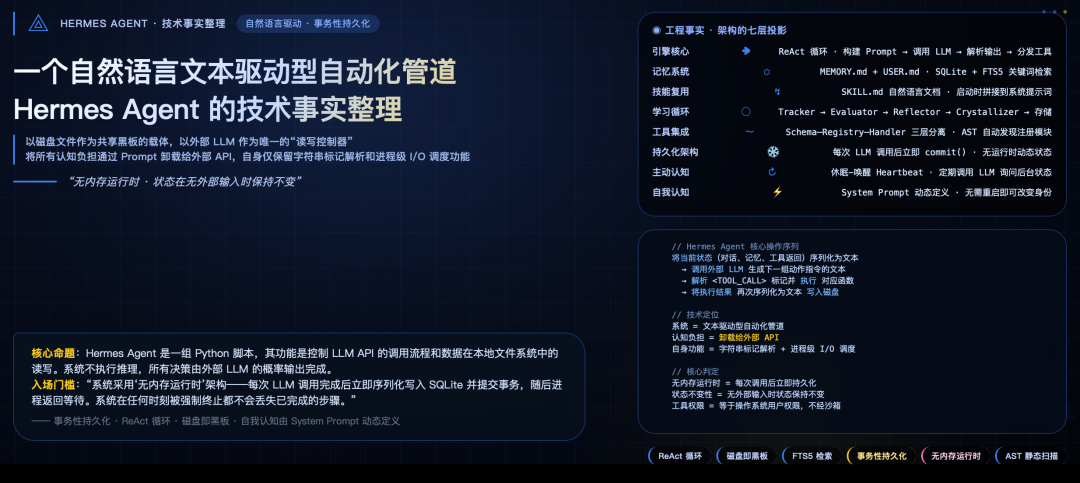
一个具备事务性持久化能力的自然语言文本驱动型自动化管道。它以磁盘文件作为共享黑板的载体,以外部 LLM 作为唯一的“读写控制器”,将所有认知负担(记忆取舍、任务规划、技能提炼、自我认知)通过 Prompt 卸载给外部 API,自身仅保留字符串标记解析和进程级 I/O 调度功能。
一、是什么
Hermes Agent 是一组 Python 脚本,其功能是控制 LLM API 的调用流程和数据在本地文件系统中的读写。
1. 一个对话循环编排器
conversation_loop.py实现了“接收输入→构建 Prompt→调用 LLM→解析输出→分发工具调用→循环”的标准 ReAct 模式。外部代码检测 LLM 输出中的特定标记(如 <TOOL_CALL>),据此调用对应的 Python 函数。
2. 一个文本文件读写系统
记忆存储在
MEMORY.md和USER.md,为纯文本文件。对话历史存储在 SQLite 数据库中,启用 FTS5 关键词检索。技能存储在
SKILL.md,为自然语言描述的步骤文档。系统在启动时读取这些文件,将其内容拼接到系统提示词中。写入管理:当记忆写入超限时,系统返回当前条目,由 LLM 自行决策替换、删除或合并。
3. 一个自动化文档生成流水线
学习循环(Tracker → Evaluator → Reflector → Crystallizer → 存储)是一个由 Python 脚本驱动的流程:
Evaluator 为条件判断(工具调用次数≥5 且任务成功)
Reflector 和 Crystallizer 调用 LLM 生成文本(反思内容和技能文档)
输出结果为
SKILL.md文件
4. 一个工具注册与发现机制
工具定义采用 Schema–Registry–Handler 三层分离。每个工具文件调用 registry.register()完成自注册,系统启动时通过 AST 扫描自动发现包含注册调用的模块。
5. 一个 LLM 的上下文拼接器
系统在每次调用 LLM 之前,将记忆文件、技能文件、对话历史、工具定义等文本内容拼接为系统提示词和用户消息。
6. 一个具有“休眠-唤醒”机制的后台进程
gateway/run.py为长期运行的进程。当无任务时,系统定期调用 LLM(如每 30 秒)询问“是否有任何需要主动处理的事情”。该机制使得系统在无用户输入时仍会消费 Token 进行后台状态反思。
7. 一个“无内存运行时”架构
每次 LLM 调用完成后,当前的对话回合、工具调用记录被立即序列化写入 SQLite 并提交事务(commit()),随后进程返回等待。系统在任何时刻被强制终止都不会丢失已完成的步骤。系统不维护运行时的“短期动态变量”,所有跨步骤的“上下文连贯性”完全依赖下一次 Prompt 构建时从磁盘重新读取和拼接。
二、不是什么
1. 不是一个独立的推理引擎
系统本身不包含推理模块。推理和决策由外部 LLM 完成。系统的工作是将 LLM 的输入输出格式化并转发。
2. 不是一个认知架构
系统未实现任何公认的认知架构模型(如 ACT-R、SOAR、CLARION、全局工作空间理论等)。其“记忆”是工程存储分层,而非认知科学意义上的“工作记忆→长期记忆”转换结构。
3. 不是一个知识图谱
记忆检索基于 FTS5 关键词匹配,而非语义相似度。系统没有定义知识实体之间的关系拓扑,也没有向量嵌入。工程的取舍前提是:预设 LLM 上下文窗口足够大(≥64k),用 FTS5 快速召回大量候选片段后全部塞入 Prompt,让 LLM 在超长上下文中自行筛选。
4. 不是一个模型训练或微调工具
技能优化(DSPy/GEPA)调整的是输入给 LLM 的提示词文本中的措辞和示例顺序,不涉及 LLM 模型权重的修改。
5. 不是一个具有独立状态演化的动力系统
系统状态在没有外部输入时保持不变。状态转移由用户输入、定时触发器或 Webhook 等外部事件驱动,而非由内部状态方程决定。“休眠-唤醒”机制虽能在无输入时触发 LLM 调用,但调用的内容由预设文本决定,系统本身不产生新的状态分支。
6. 不是一个决策优化系统
系统不定义效用函数、损失函数或成本函数。每一步调用哪个工具或生成哪段文本,由 LLM 的概率输出决定。Evaluator 的判断依据为硬性阈值,而非贝叶斯决策准则。
7. 不是一个内生约束系统
系统没有定义独立于 LLM 的约束源来锚定或验证 LLM 的输出。所谓“记忆策展”是将写入失败的决策交给同一个 LLM 处理。
8. 没有在代码层面固化“自我”
系统的“身份”由 prompt_builder在每次循环时动态拼接的 System Prompt 文本所赋予。修改 USER.md或系统提示词模板,系统的“自我认知”会立即改变,无需重启或重新训练。
9. 知识真值的验证委托给 LLM 的文本判断
Evaluator 判断“任务是否成功”时,并不具备外部环境状态的直接感知能力。其判断依据是 LLM 对执行结果日志的文本理解,或工具返回的 exit_code。系统没有通过确定性逻辑(如单元测试)来证明技能的有效性。
10. 工具执行不经过沙箱隔离
core/registry/中的 execute_tool函数直接使用 Python 的 subprocess或动态导入执行注册的函数。系统假设运行环境可信,且工具代码本身无恶意。系统赋予 LLM 的工具调用能力,其权限边界等于运行该 Python 进程的操作系统用户权限,未在系统层面实施额外的能力管控。
11. 学习过程存在先验信息损耗
Reflector生成反思文本时,不直接获取原始用户输入和原始输出的完整语义,而是读取 Tracker截取的最后 N 条工具调用摘要。如果一次长任务涉及超过上下文窗口的中间步骤,早期上下文会被截断。沉淀为 SKILL.md的知识是基于“执行轨迹缩略图”生成的,而非基于“完整任务全景图”。
三、组件与技术实现对照
MEMORY.mdUSER.md(1375字符)两个文本文件;SQLite + FTS5 关键词检索 | ||
SKILL.md | ||
SKILL.md中的措辞、示例顺序和模板结构 | ||
conversation_loop.py、core/memory/、core/learning/、core/registry/等) | ||
四、与公开宣传的对照
五、技术画像
Hermes Agent 在工程底层等价于以下操作序列:
将当前状态(对话、记忆、工具返回)序列化为文本 → 调用外部黑盒(LLM)生成下一组动作指令的文本 → 解析文本并执行对应函数 → 将执行结果再次序列化为文本写入磁盘。
综合所有技术事实,可进一步精炼为:
一个具备事务性持久化能力的文本驱动型自动化管道。它以磁盘文件作为共享黑板的载体,以外部 LLM 作为唯一的“读写控制器”,将所有认知负担(记忆取舍、任务规划、技能提炼、自我认知)通过 Prompt 卸载给外部 API,自身仅保留字符串标记解析和进程级 I/O 调度功能。
六、补充
1. 对应 二.11
Reflector 的输入是 Tracker 截取的最后 N 条工具调用摘要,而非完整对话日志。Crystallizer 基于摘要生成 SKILL.md。
系统未定义任何机制来计算原始对话日志与 SKILL.md之间的信息熵差异或互信息保留率。从原始日志到技能文档的转换是一个有损压缩过程,但其损耗未被量化。
2. 对应 二.7
记忆写入超限时,系统不执行确定性删除逻辑,而是将决策权交还给 LLM。prompt_builder.py动态构建 System Prompt,其中的规则由 LLM 在对话中决策是否修改。
系统缺少独立于 LLM 的外部参考输入(如事实校验器、状态验证器)来提供负反馈信号。Evaluator 的判定依据为 LLM 对日志的文本理解或 exit_code。
3. 对应 二.2
conversation_loop.py的单层循环中,LLM 在同一上下文中同时承担任务执行、自我评判、规则制定三重身份。prompt_builder.py将所有内容压入同一 Prompt,无结构化分层。
系统没有定义“元认知层”来监督“认知层”的独立模块。任何监督行为都需要 LLM 在同一个上下文窗口中自行完成。
4. 对应 二.2、二.8
MEMORY.md和 SKILL.md是静态文本文件,仅在构建 Prompt 时被读取并拼接为文本。这些文本不作为系统架构的一部分被内化——没有对应的数据结构、状态变量或控制流逻辑。
系统没有定义任何认知图式来动态更新对世界的理解。所有“更新”表现为文本替换。
5. 对应 二.6
工具选择的决策路径为:构建包含工具定义的 Prompt → 调用 LLM → 解析 LLM 输出的 <TOOL_CALL>标记。路径选择由 LLM 的概率采样决定。
系统无期望效用计算,无折现因子,无风险偏好参数。Evaluator 的判定依据为硬性阈值(工具调用次数≥5 且任务成功),不进行贝叶斯后验概率更新。
6. 对应 二.5、一.7
系统状态在没有外部输入时保持不变。每一次用户输入或定时心跳都是对系统的外部冲击,状态转移由这些事件驱动,而非由内部状态方程决定。
系统没有定义在时间轴上连续演化的状态变量。昨天的 SKILL.md和今天的 SKILL.md之间不存在动力学连续性约束。系统状态可以在无外部做功的情况下发生突变。
7. 对应 二.11、一.2、一.3
系统维持低熵结构(提炼技能)的唯一手段是调用 LLM 生成文本。LLM 的采样过程本身是一个引入随机性的过程。技能提炼的输出基于截断摘要,而非完整任务信息。
系统不向确定性校验环境输出“废热”(即通过确定性逻辑验证并固化的事实)。每一次记忆重写和技能生成都在消耗 API 能量,但系统没有将任何结果固化为不可变的结构。技能文档可以在后续被再次重写。
8. 负反馈与自指递归的区别
在控制论中,负反馈要求系统有一个独立于被控对象的参考输入,通过感知输出与参考值的偏差来修正行为。
本系统的逻辑是:让被控对象(LLM)自己去修改控制器(System Prompt)的规则参数。这不是负反馈,而是自指递归。系统缺少独立于 LLM 的参考输入来提供负反馈信号。
七、技术事实汇总
系统是一组 Python 脚本,管理 LLM API 调用和本地文件读写。
记忆存储为纯文本文件(.md)和 SQLite 数据库(FTS5 关键词检索)。
技能存储为自然语言 Markdown 文档,复用时拼接到系统提示词。
学习循环是 Python 脚本驱动的流水线,LLM 参与两个文本生成环节(反思、技能文档)。
技能优化调整的是输入给 LLM 的提示词文本,不改变模型参数。
系统不包含独立于 LLM 的推理模块、决策优化模块或内生约束模块。
核心引擎(对话循环)是 ReAct 模式的标准实现。
工具发现采用 AST 静态扫描自动化注册。
工具执行不经沙箱隔离,权限边界等于操作系统用户权限。
系统未实现任何公认的认知架构模型。
系统的“自我认知”由 System Prompt 动态定义,未固化于代码。
知识真值的验证委托给 LLM 对日志文本的理解,而非确定性逻辑。
学习循环的 Reflector 阶段输入为截断后的执行摘要,存在先验信息损耗。
系统存在“休眠-唤醒”的定时 LLM 调用机制,但调用内容由预设文本决定。
检索策略为“FTS5 召回 + 超长上下文筛选”,用算力换工程复杂度。
系统采用“无内存运行时”架构:每次 LLM 调用完成后立即持久化,不维护运行时动态状态。
系统没有定义状态在时间轴上演化的动力学方程,状态转移由外部事件驱动。
系统不向确定性校验环境输出固化结果,技能文档可在后续被重写。
系统缺少独立于 LLM 的参考输入来提供负反馈信号。
社区反馈中存在 Token 消耗、学习可控性、项目维护效率方面的讨论。
本文基于公开源码和社区讨论做技术事实梳理,不包含价值判断。